TensorRT Edge-LLM выполнил агентный тест MLPerf на Jetson AGX Thor в 6,4 раза быстрее llama.cpp
16.09.2026
NVIDIA опубликовала результат TensorRT Edge-LLM в новом тесте Edge Agentic из MLPerf Inference v6.1. На одном комплекте Jetson AGX Thor система обработала 1007 шагов диалога за 24 минуты 36 секунд против 2 часов 37 минут у эталонного запуска llama.cpp. Пропускная способность составила 52,33 токена в секунду, точность в тесте вызова функций BFCL — 87,94%.
Консорциум MLCommons включил Edge Agentic Inference в набор тестов MLPerf Inference v6.1. Нагрузка воспроизводит работу программного агента: модель последовательно вызывает инструменты, получает результаты и продолжает диалог с растущим контекстом. Тест содержит 20 диалогов и 1007 шагов, а максимальная длина входных данных достигает примерно 23,5 тыс. токенов.
NVIDIA провела тест модели Qwen3.6-27B в режиме SingleStream на одном комплекте разработчика Jetson AGX Thor со 128 Гбайт объединённой памяти. TensorRT Edge-LLM завершил нагрузку за 24 минуты 36 секунд, показав 52,33 токена в секунду. Медианное время до первого токена составило 247,12 мс, время генерации одного выходного токена — 14,68 мс.
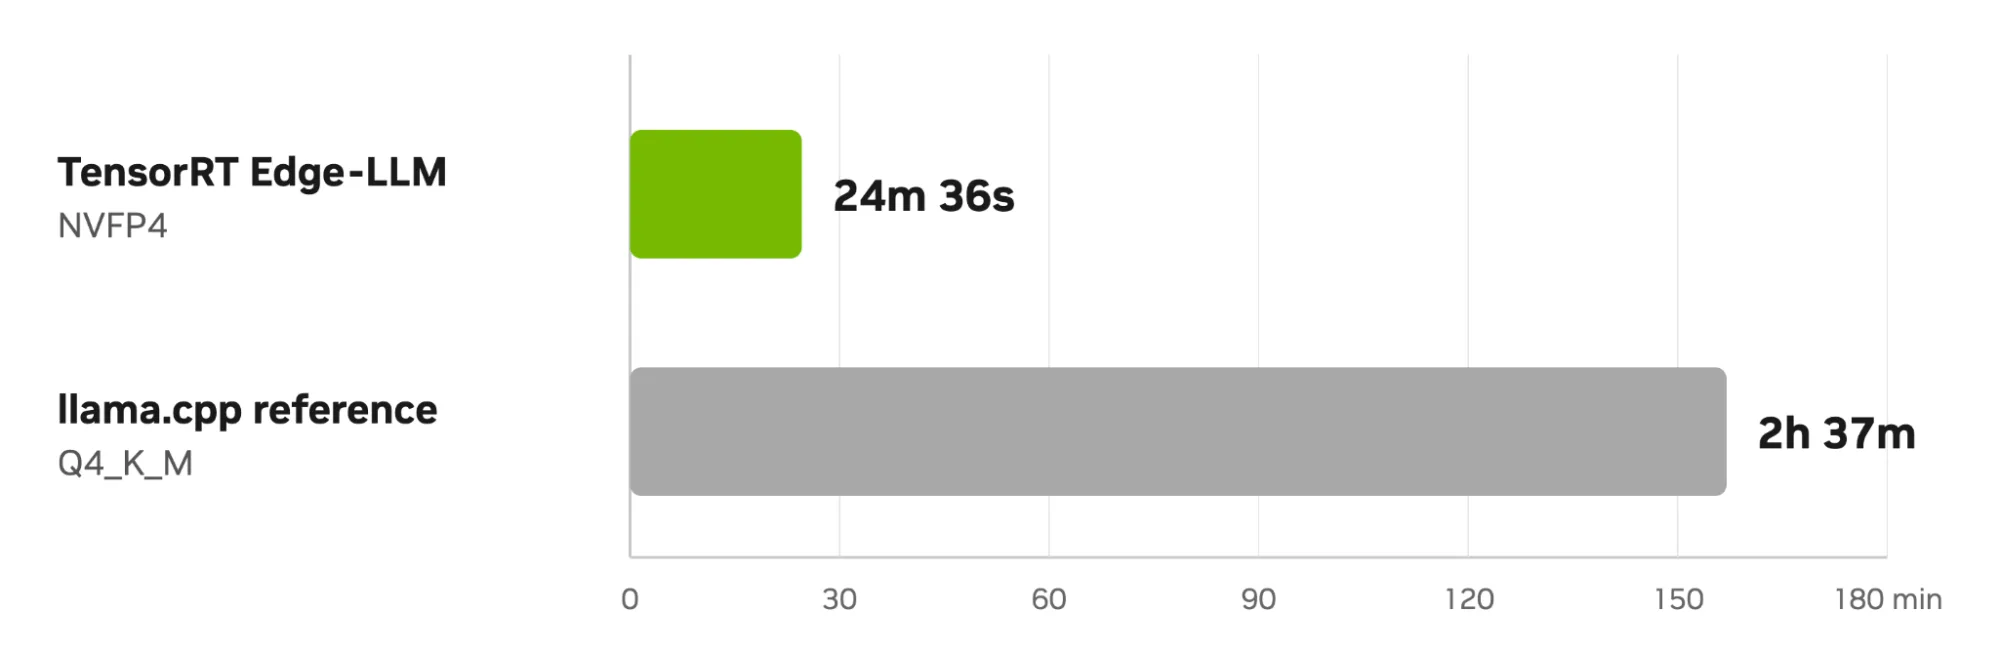
Эталонный запуск llama.cpp на том же типе устройства и с той же моделью занял 2 часа 37 минут. Конфигурации различались не только средой выполнения: TensorRT Edge-LLM использовал формат NVFP4 для весов и активаций и FP8 для KV-кэша, тогда как llama.cpp применял квантование Q4_K_M.
Среди задействованных оптимизаций NVIDIA называет повторное использование KV-кэша и рекуррентного состояния между шагами агента, а также древовидное предсказание нескольких токенов. Около 96% входных токенов обслуживались из уже заполненного кэша. Конфигурация теста и команды сборки опубликованы в репозитории TensorRT Edge-LLM.
Источник: developer.nvidia.com