Проект ЦИТадель
Обзоры • курсы • практикумы
Не «что нажать», а «как устроено»
Runway разрабатывает потоковую генерацию видео с управлением в реальном времени
20.09.2026
Runway исследует модель, которая будет генерировать видео кадр за кадром и сразу реагировать на текстовые команды пользователя. Компания рассчитывает применять технологию в интерактивных приложениях, играх, робототехнике и симуляторах, но сроки её выпуска пока не объявлены.
Компания Runway, разработчик моделей генеративного видео, описала подход к потоковой генерации роликов. Вместо ожидания готового результата пользователь сможет менять сцену во время воспроизведения с помощью команд, а модель — последовательно создавать новые кадры с учётом уже сгенерированного материала.
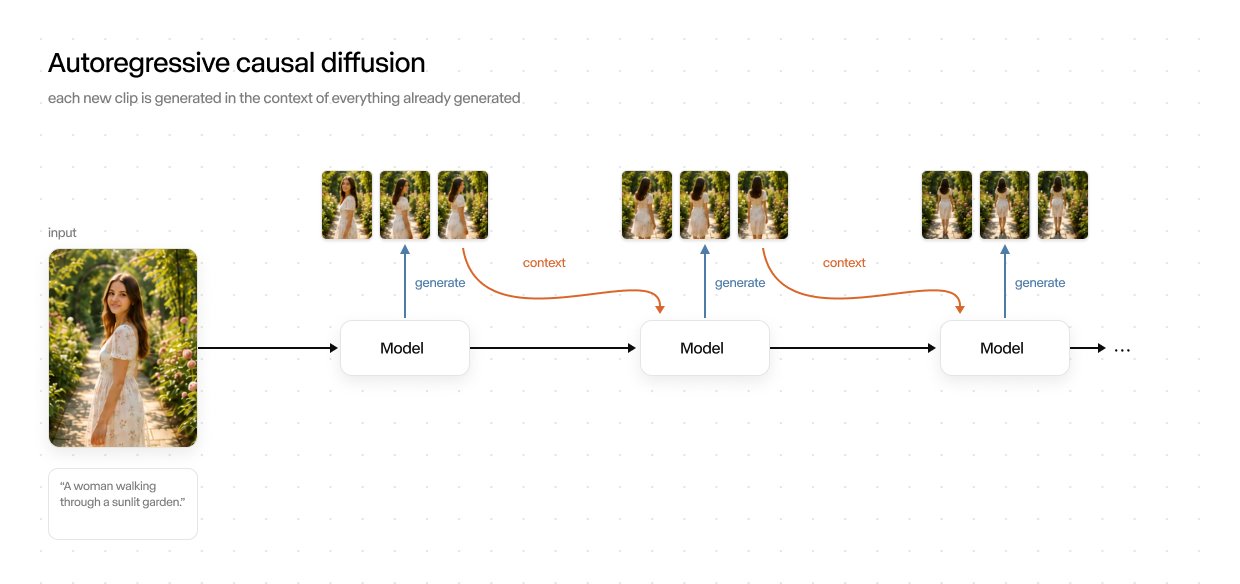
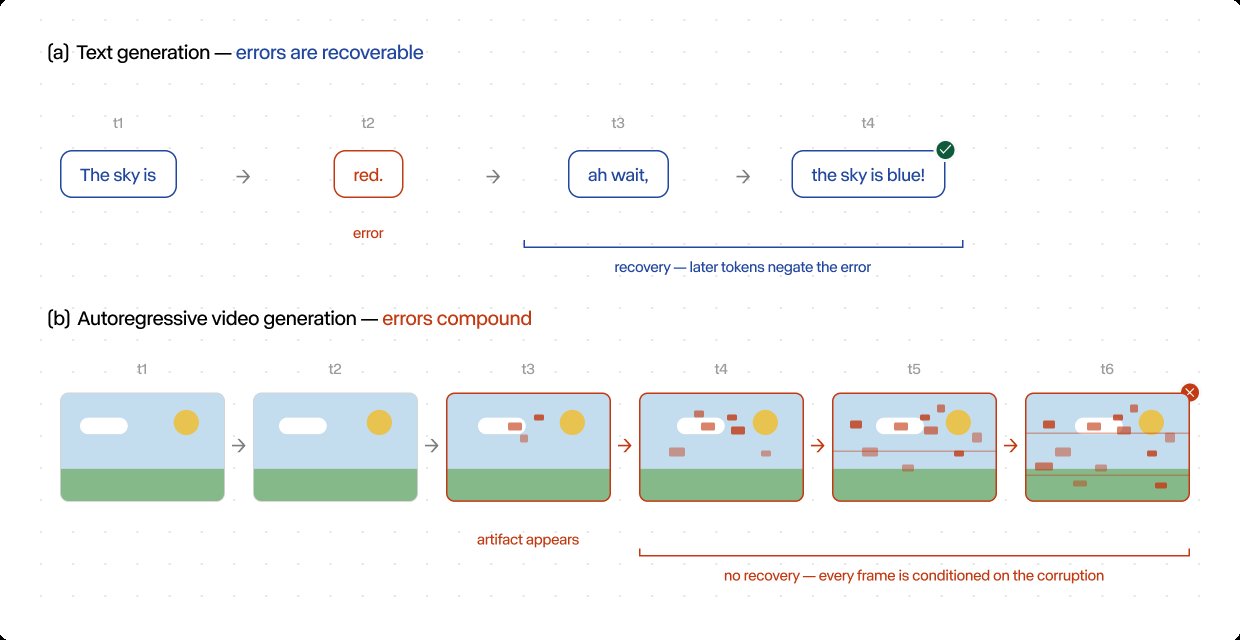
Одна из основных технических проблем — накопление ошибок: дефект в одном кадре становится частью контекста для следующих и может постепенно исказить всю сцену. Для повышения устойчивости Runway обучает модель не только на корректных исходных данных, но и на её собственных результатах, чтобы система училась компенсировать отклонения.
Потоковый режим требует, чтобы каждый кадр создавался быстрее его воспроизведения, причём вычислительные ресурсы должны одновременно обслуживать несколько сеансов. В Runway считают, что ускорение вывода также сократит затраты GPU на единицу результата.
Технология связана с моделью мира GWM-1, построенной на базе Gen-4.5 и поддерживающей управляющие сигналы, включая движения камеры, звук и команды для роботов. Среди предполагаемых применений названы игры, образование, робототехника и виртуальные среды для проверки автономных систем. Сроки предоставления новой системы пользователям Runway не сообщила.
Источник: the-decoder.com