Проект ЦИТадель
Обзоры • курсы • практикумы
Не «что нажать», а «как устроено»
Курс «Распределённые системы». Глава 6. Консенсус: Raft
Цели главы. Центральная глава курса. Всё предыдущее сходится сюда: failover без split brain (глава 5) — это консенсус; линеаризуемость (глава 4) реализуется консенсусом; FLP (глава 3) очерчивает его пределы. Разберём Raft полностью — выборы, репликацию журнала, гарантии безопасности с их самой тонкой деталью, смену состава кластера — и практические вопросы, отделяющие учебник от эксплуатации: линеаризуемые чтения, ограждение, снимки. Paxos — обзорно, для чтения литературы. Завершает главу лабораторная: трёхузловой etcd, убийство лидера и попытка устроить split brain (спойлер: не выйдет — и вы увидите, почему).
6.1. Постановка: реплицируемый автомат
Требуется не «согласовать одно значение» (формулировка главы 3 была минимальной для теорем), а поддерживать реплицируемый автомат: несколько узлов исполняют одну и ту же последовательность детерминированных команд и потому проходят одни и те же состояния. Вся задача сводится к одному: согласовать содержимое упорядоченного журнала команд — дальше детерминизм делает остальное. Консенсус по журналу должен обеспечить: безопасность — зафиксированные (committed) записи журнала никогда не теряются и не переупорядочиваются, все узлы применяют один и тот же префикс; живость — при работоспособном большинстве и стабильной сети система продвигается. Помним рамку FLP: в crash-recovery-модели с корректными (не византийскими) узлами и долговечным состоянием протокола безопасность будет безусловной — без каких-либо временных предположений; живость — при частичной синхронности.
Магическое число всей главы — большинство (кворум): в кластере из 2f+1 узлов любые два большинства пересекаются хотя бы в одном узле. Пересечение запрещает избрать двух лидеров в одном терме, потому что общий избиратель голосует лишь раз. Для сохранности зафиксированных записей одного пересечения недостаточно: вместе с ним работают проверка актуальности журнала кандидата, Log Matching и правило фиксации записей текущего терма — полный аргумент дан в 6.4. Кластеры делают нечётными: 3 узла терпят 1 отказ, 5 — 2; чётный четвёртый узел не добавляет отказоустойчивости (большинство от 4 — это 3), лишь стоимость.
6.2. Raft: роли, термы, выборы
Каждый узел в одном из трёх состояний: ведомый (follower), кандидат, лидер. Время разбито на монотонно растущие термы; в терме может не быть лидера, но избран не более чем один. Каждый узел помнит наибольший виденный терм, всякое сообщение несёт терм отправителя, и сообщение с устаревшим термом отвергается, а узел, увидевший больший терм, становится ведомым. Терм ограждает сам протокол Raft от сообщений старых эпох, но для внешнего ресурса всё равно нужен отдельный fencing-токен (6.6).
Выборы. Лидер периодически шлёт всем пустые AppendEntries (сердцебиение). Ведомый, не слышавший лидера в течение случайного тайм-аута (типично 150–300 мс в примере статьи, но в эксплуатации диапазон выбирают по задержкам сети и диска), объявляет себя кандидатом: увеличивает терм, голосует за себя и рассылает RequestVote. Узел отдаёт голос при двух условиях: в этом терме ещё не голосовал (одно голосование на терм — хранится на диске!) и журнал кандидата не отстаёт от его собственного (сравнение по терму и индексу последней записи — эта проверка станет ключом к безопасности в 6.4). Кандидат, собравший большинство, — лидер терма; получивший AppendEntries с термом не меньше своего — признаёт чужое лидерство; при расколе голосов никто не побеждает, тайм-аут истекает, начинается новый терм. Случайность тайм-аутов снижает вероятность повторного раскола голосов и ускоряет выборы. Она не превращает Raft в асинхронный рандомизированный консенсус: живость Raft по-прежнему требует периода, когда обмен сообщениями успевает завершаться заметно быстрее election timeout. В худшем случае завершение не гарантировано, безопасность сохраняется.
6.3. Репликация журнала
Репликация журнала идёт через RPC AppendEntries(терм, идентификатор лидера, предыдущий индекс, предыдущий терм, записи, commitIndex); выборы используют отдельный RequestVote, а передача снимка — InstallSnapshot. Лидер принимает команду клиента, дописывает в свой журнал (запись = команда + терм) и рассылает. Ведомый принимает записи, только если у него в журнале по «предыдущему индексу» стоит запись с «предыдущим термом» — проверка согласованности префикса. Индукция по этой проверке даёт Log Matching: если у двух узлов записи с одинаковыми индексом и термом, то совпадают и они, и весь префикс до них.
Расхождения (ведомый отстал или содержит хвост от свергнутого лидера) лечатся откатом: лидер, получив отказ проверки, уменьшает индекс для этого ведомого и пробует раньше, найдя точку совпадения — перезаписывает ведомому весь хвост своим. Незафиксированные хвосты стираемы — это законно; вся тяжесть гарантий лежит на понятии фиксации: запись зафиксирована, когда лидер узнал о её сохранении на большинстве узлов (с оговоркой 6.4). Лидер продвигает commitIndex, сообщает его в следующих AppendEntries, узлы применяют зафиксированный префикс к автомату. Клиент получает ответ после фиксации — и с этого момента запись переживает любые дальнейшие выборы и отказы, допускаемые моделью (одновременная потеря большинства дисков — уже за её пределами).
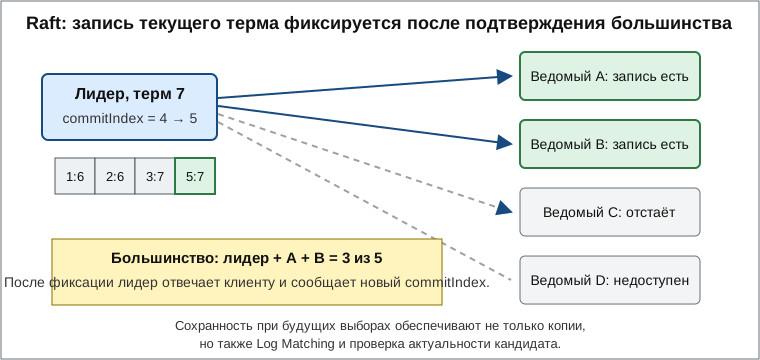
Рис. 6.1. Нормальный путь записи Raft; правила будущих выборов, необходимые для сохранности большинства, разобраны в следующем разделе.
6.4. Безопасность: почему зафиксированное не теряется
Докажем Leader Completeness аккуратно: одного пересечения большинств недостаточно. Пусть лидер терма T зафиксировал запись x своего терма, то есть x сохранило большинство M₁. Предположим противное и выберем первый последующий терм U, лидер которого x не содержит. Избирающее большинство M₂ пересекается с M₁ в узле v. По минимальности U все промежуточные лидеры содержали x, поэтому ни один из них не мог заставить v удалить x; в момент голосования v всё ещё хранит её. Кандидат U обязан быть не менее актуален, чем v. Если его последний терм не превосходит T, правило сравнения терма и индекса не позволит обойти x. Если последний терм кандидата больше T, соответствующую запись создал промежуточный лидер, который по минимальности U уже содержал x; свойство Log Matching означает, что кандидат вместе с этой более поздней записью также получил весь префикс с x. В обоих случаях кандидат без x не может получить голос v — противоречие. Значит, каждый будущий лидер содержит x. Именно здесь совместно работают пересечение большинств, правило актуальности журнала, Log Matching и ограничение фиксации записей текущего терма.
Тонкость, на которой ломались самодельные реализации (рис. 8 статьи о Raft): лидер не имеет права объявить зафиксированной запись чужого терма, лишь пересчитав копии — существует сценарий, где запись старого терма лежит на большинстве, но будет законно стёрта лидером промежуточного терма, успевшим избраться без неё. Правило Raft: лидер фиксирует по числу копий только записи своего терма, а записи прежних термов фиксируются вместе с ними по Log Matching. Поэтому реализации часто добавляют после выборов пустую запись текущего терма (no-op): зафиксировав её, лидер заодно фиксирует унаследованный префикс. Разбор сценария — упражнение 4, самое поучительное в главе.
6.5. Смена состава кластера
Добавить или убрать узел — значит изменить само определение «большинства», и наивная одномоментная замена конфигурации Cold → Cnew опасна: в переходный миг часть узлов считает большинством одно, часть — другое, и два непересекающихся «большинства» могут избрать двух лидеров. Решения: совместный консенсус (joint consensus) — промежуточная конфигурация Cold,new, где решения требуют большинств обеих конфигураций; либо протокол одиночных изменений, где состав меняется строго на один узел, изменение фиксируется до начала следующего, а добавляемый узел предварительно догоняет журнал. Одного бытового правила «добавлять по одному» без этих протокольных условий недостаточно. Изменение конфигурации само едет записью журнала — красиво замкнутая конструкция.
6.6. Эксплуатационные вопросы
- Линеаризуемые чтения. Читать «просто с лидера» недостаточно: лидер мог быть только что свергнут и не знать об этом (зомби — глава 5). Честные варианты: прогнать чтение записью через журнал (дорого); ReadIndex — лидер запоминает commitIndex, подтверждает своё лидерство раундом сердцебиений с большинством и отвечает после применения этого индекса; lease — лидер отвечает без раунда в пределах арендованного интервала времени (быстро, но корректность зависит от границ дрейфа часов — глава 2 научила относиться к этому с подозрением). В etcd обычное Range-чтение линеаризуемо (ReadIndex), а режим serializable обслуживается локально, без обращения к лидеру, и может вернуть устаревшие данные — увидите в лабораторных 2 и 5.
- Ограждение вовне. Терм защищает журнал, но не внешние ресурсы: клиент, взявший в etcd «блокировку» и зависший, может очнуться после её истечения и писать во внешнее хранилище параллельно с новым владельцем. Лекарство то же, что в 5.2: блокировка выдаётся с монотонным номером (в etcd — ревизия ключа), и внешний ресурс отвергает запросы со старым номером. Распределённая блокировка без поддержки на стороне ресурса — самообман; это стоит повторить дважды.
- Снимки. Журнал бесконечно не хранят: периодически состояние автомата сбрасывается в снимок, журнал усекается, отставшим узлам вместо древнего хвоста передаётся снимок (InstallSnapshot). Не путать с распределённым снимком из главы 2: там надо согласовать разрез между процессами и каналами, здесь снимок — состояние одного автомата на зафиксированном индексе, а согласованность уже обеспечена журналом.
6.7. Paxos: историческая перспектива
Paxos (Лэмпорт, 1989/1998) решает согласование одного значения двумя фазами: prepare — предложитель выбирает новый номер предложения и собирает у большинства принимающих обещания не принимать предложений с меньшими номерами — вместе со сведениями о том, что они уже приняли; если среди ответов есть принятые значения, он обязан продвигать то, у которого наибольший номер предложения (аналог Leader Completeness), иначе волен предложить своё; accept — просит большинство принять пару «номер, значение». Многократный Paxos с постоянным предложителем (Multi-Paxos) сводится к схеме, структурно эквивалентной Raft: стабильный лидер + реплицируемый журнал + номера эпох. Разница — в изложении и степени свободы деталей: Paxos — ядро с недосказанной инженерией вокруг (что признавали и в Google, реализуя Chubby), Raft — полный протокол, спроектированный ради понятности, с эталонными реализациями (etcd/raft, HashiCorp raft) — потому индустриальный выбор по умолчанию сегодня он. Читателю статей знать Paxos необходимо; строителю систем — начинать с Raft.
Итоги главы
- Консенсус в практической форме = согласованный реплицируемый журнал + детерминированный автомат; вся арифметика гарантий — пересечение большинств в кластере 2f+1.
- Термы = встроенное ограждение; одно голосование на терм (на диске) + проверка актуальности журнала кандидата обеспечивают безопасность; случайные тайм-ауты уменьшают повторные расколы голосов, а живость требует периода частичной синхронности.
- Проверка префикса в AppendEntries даёт Log Matching; Leader Completeness сохраняет зафиксированное сочетанием пересечения большинств, проверки актуальности кандидата и правила фиксации текущего терма.
- Тонкость фиксации: лидер фиксирует по счёту копий только записи своего терма; no-op при вступлении.
- Состав кластера меняется по одному узлу (или через joint consensus); конфигурация едет журналом.
- Эксплуатация: линеаризуемые чтения — ReadIndex/lease, не «просто с лидера»; блокировки требуют ограждения на стороне ресурса; журнал усекается снимками.
Упражнения
- Кластер из 5 узлов, узел n5 отрезан сетью и бесконечно устраивает выборы, наращивая терм до огромных значений. Что произойдёт при восстановлении связности? Почему это неприятно (лишние перевыборы), но безопасно? Найдите название механизма, смягчающего проблему в современных реализациях (pre-vote), и объясните его идею.
- Докажите: в одном терме не могут быть избраны два лидера. Какие два факта используются (пересечение большинств; одно голосование на терм) и почему голос обязан храниться на диске (сценарий с перезагрузкой избирателя)?
- Лидер терма 2 с журналом [x₁, x₂] реплицировал x₂ на 2 узла из 5 (включая себя) и отказал. Перечислите, кто может быть избран в терме 3 и судьбу x₂ в каждом случае. В какой момент x₂ стала бы неуничтожимой?
- Восстановите сценарий «рис. 8»: 5 узлов; лидер терма 2 записал y на себя и ещё один узел и пал; лидером терма 3 избрался узел без y (возможно? проверьте по правилу голосования), записал z локально и пал; лидер терма 4 (с y) дореплицировал y на большинство — вправе ли он объявить y зафиксированной? Постройте продолжение, в котором y, лежащая на большинстве, законно стирается, и сформулируйте, как правило «фиксировать только свой терм» + no-op закрывает сценарий.
- Докажите, что при изменении состава по одному узлу большинства старой и новой конфигураций пересекаются (разберите случаи добавления и удаления узла из кластера размера n). Постройте контрпример пересечению при одновременной замене двух узлов из трёх.
- Клиент А взял в etcd блокировку с TTL 10 с и завис на 15; блокировку получил клиент B; A очнулся и пишет во внешний файл. Спроектируйте протокол с ревизией etcd как fencing-токеном: что хранит файловый сервис, что проверяет, какой запрос отвергнет. Почему TTL сам по себе проблему не решает принципиально (глава 1: чем «завис» отличается от «медленный»)?
Ответы и указания. 1: узел с гигантским термом при воссоединении переведёт действующего лидера в ведомые и вызовет выборы; безопасность цела, но работа прервётся. Pre-vote сначала проверяет возможность собрать голоса без увеличения терма, поэтому изолированный узел его не наращивает. 2: два избирающих большинства обязаны пересечься, а общий узел не может голосовать дважды в одном терме. Если голос не записать на диск, после перезагрузки этот узел забудет первый голос и сможет обеспечить оба большинства. 3: среди четырёх живых узлов x₂ хранит один. Он может быть избран и сохранить x₂, но три узла без x₂ также могут избрать своего кандидата и законно стереть незафиксированный хвост. x₂ становится неуничтожимой после фиксации по правилу 6.4, а не просто после появления некоторого числа копий. 4: кандидат без y в терме 3 получает голоса трёх узлов без y и пишет z терма 3 только себе. В терме 4 узел с y получает другие три голоса и раскладывает y терма 2 на большинство, но не вправе фиксировать её одной арифметикой копий. Затем носитель z, чей последний терм 3 новее терма 2, собирает большинство и перезаписывает y. Если лидер терма 4 сначала зафиксирует no-op своего терма, его большинство получит более свежий журнал и кандидат с z уже не пройдёт проверку актуальности. 5: при добавлении или удалении одного узла размеры старого и нового большинства в общей совокупности дают сумму больше числа различных узлов, поэтому пересечение обязательно; при {A,B,C}→{A,D,E} допустимы непересекающиеся большинства {B,C} и {D,E}. Это арифметическое условие применяется внутри протокола конфигурационных записей, а не заменяет его. 6: файловый сервис хранит максимальную принятую ревизию блокировки и принимает запись только с токеном не меньше неё. После выдачи B более новой ревизии запрос проснувшегося A со старым токеном отвергается. TTL определяет срок аренды в координаторе, но не может остановить зависший процесс или заставить внешний ресурс забыть его запрос.
Лабораторная работа 2. Кластер etcd: выборы, отказы, разделение
Цель — наблюдать термы, выборы и поведение большинства и меньшинства, а затем связать результаты с правилами Raft. Стенд — три контейнера etcd: docker-compose.yml и команды запуска приложены к курсу; клиент etcdctl уже находится в образе.
Задание 1. Кто лидер. Поднимите кластер; командой etcdctl endpoint status -w table --endpoints=... найдите лидера и текущий терм (поле raft term). Запишите пару ключей, прочитайте с каждого узла.
Задание 2. Смерть лидера. docker kill контейнеру-лидеру. Засеките по endpoint status: новый лидер, новый терм, время недоступности записи (цикл etcdctl put с меткой времени — сколько запросов отвалилось?). Верните узел — убедитесь, что он стал ведомым и догнал журнал. В отчёт: терм до/после, время переизбрания.
Задание 3. Меньшинство. Изолируйте один узел (docker network disconnect) и дождитесь, пока линеаризуемое чтение через его локальный endpoint начнёт стабильно завершаться ошибкой; только после этого запишите новый ключ в оставшееся большинство. Проверьте на изолированном узле: запись — отказ; линеаризуемое чтение — отказ; чтение с флагом --consistency=s (серийное) — успех, но нового ключа в нём нет: данные замерли на границе разделения. Такая последовательность исключает гонку, при которой запись успевает реплицироваться одновременно с разрывом сети. Сформулируйте увиденное в терминах CAP (глава 3) и режимов чтения (6.6). В отчёт: таблица «операция → большинство/меньшинство → результат».
Задание 4. Попытка split brain. Разрежьте сеть 1|2: лидер в меньшинстве. Пронаблюдайте: старый лидер не может фиксировать новые записи без большинства, двойка избирает нового лидера с большим термом и фиксирует запись. Старый лидер до получения сообщения с большим термом может локально считать себя лидером, но подтвердить конфликтующую запись не может. Восстановите сеть: он переходит в состояние ведомого, а незафиксированный хвост, если такой появился, согласуется через AppendEntries. Сверьте ключи на всех узлах. В отчёт: почему не могли быть зафиксированы конфликтующие записи — со ссылками на пересечение большинств, термы и правила журнала из 6.1–6.4.
Задание 5. Выборы при длительной паузе. Определите контейнер-лидер и приостановите его командой docker pause дольше настроенного election timeout (в приложенном стенде используется стандартное значение etcd около 1000 мс). На двух работающих узлах наблюдайте новый терм и лидера, затем выполните docker unpause и убедитесь, что прежний лидер стал ведомым. Повторите опыт с несколькими длительностями паузы по обе стороны election timeout и объясните, почему граница наблюдаемого переключения не обязана совпадать с ним до миллисекунды. Этот опыт воспроизводим в данном стенде и не требует tc или возможности NET_ADMIN. В отчёт: длительности пауз, произошедшие выборы и правило выбора election timeout относительно задержек сети и диска.
Задание 6*. Fencing на ревизиях. Реализуйте скетч из упражнения 6: два клиента-скрипта конкурируют за ключ-блокировку (etcdctl lease grant + put с lease), «внешний ресурс» — файл, дописываемый только при предъявлении ревизии не меньше запомненной. Продемонстрируйте, как зависший клиент с устаревшей ревизией получает отказ.
Литература к главе
- D. Ongaro, J. Ousterhout, "In Search of an Understandable Consensus Algorithm (Extended Version)," 2014. raft.github.io/raft.pdf — обязательное чтение; наглядная визуализация: raft.github.io.
- D. Ongaro, "Consensus: Bridging Theory and Practice," PhD thesis, Stanford, 2014 — полная версия с изменением состава и оптимизациями.
- L. Lamport, "Paxos Made Simple," 2001.
- T. Chandra, R. Griesemer, J. Redstone, "Paxos Made Live — An Engineering Perspective," PODC, 2007.
- Документация etcd: интерфейс, гарантии, эксплуатация. etcd.io/docs